Il vocabolario dell’intelligenza artificiale cresce più in fretta dei modelli stessi. Ogni settimana compaiono nuovi termini, nuovi acronimi, nuove distinzioni che separano chi capisce da chi annuisce. Capire le parole non significa capire tutto, ma è la condizione necessaria per non essere travolti dalle narrazioni, spesso contrastanti, di chi costruisce questi sistemi.
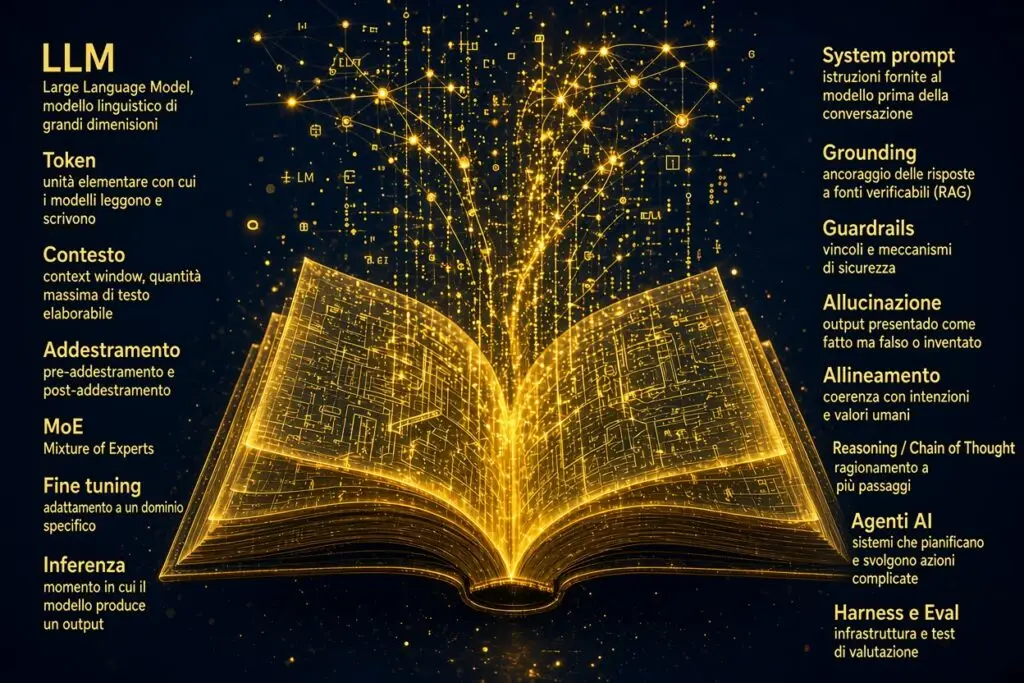
Dopo il Piccolo dizionario di Claude dedicato all’ecosistema Anthropic, questo secondo dizionario raccoglie diciotto voci che coprono il linguaggio tecnico più frequente nel dibattito attuale: dall’architettura dei modelli alla loro valutazione, passando per sicurezza, addestramento e autonomia.
Il piano dell’opera
| Termine | In parole semplici | A cosa serve |
|---|---|---|
| LLM | Un modello linguistico addestrato a prevedere il testo successivo | Generare e comprendere linguaggio |
| Token | I pezzi in cui il modello divide il testo | Leggere e generare contenuti |
| Contesto | Le informazioni che il modello può elaborare insieme a una richiesta | Lavorare su testi e conversazioni lunghe |
| Embedding | Una rappresentazione numerica del significato di un contenuto | Cercare e confrontare informazioni per somiglianza |
| Addestramento | Il processo con cui il modello impara dai dati | Costruire le capacità di base del modello |
| MoE | Un’architettura che attiva solo una parte degli esperti disponibili | Aumentare la capacità del modello contenendo il costo di elaborazione |
| Fine tuning | Un ulteriore addestramento su dati più specifici | Adattare un modello a compiti o domini particolari |
| Inferenza | Il momento in cui il modello elabora un input e produce un output | Usare concretamente il modello |
| System prompt | Le istruzioni che definiscono come deve comportarsi il modello | Stabilire regole, priorità e comportamento |
| Grounding | Collegare le risposte a informazioni esterne e verificabili | Ridurre il rischio di errori e allucinazioni |
| Guardrails | Regole e controlli che limitano comportamenti indesiderati | Aumentare sicurezza e affidabilità |
| Allucinazione | Un’informazione falsa o inventata presentata dal modello come vera | Individuare uno dei principali limiti degli LLM |
| Allineamento | Rendere il comportamento del modello coerente con obiettivi e vincoli | Aumentare utilità e sicurezza |
| Reasoning | L’elaborazione di più passaggi intermedi per affrontare un problema | Risolvere compiti complessi |
| Chain of Thought | L’esplicitazione dei passaggi intermedi di un ragionamento | Aiutare il modello in alcuni compiti di logica, matematica e pianificazione |
| Agenti AI | Sistemi che pianificano e compiono più azioni per raggiungere un obiettivo | Svolgere compiti articolati usando strumenti |
| Harness | L’infrastruttura che gestisce strumenti, stato, esecuzione e ambiente di un sistema AI | Far funzionare e testare sistemi complessi |
| Eval | Un test strutturato per misurare capacità o comportamenti | Valutare modelli e individuare punti deboli |
I fondamentali
LLM: la sigla sta per Large Language Model, modello linguistico di grandi dimensioni, ed è il tipo di categoria di modello alla base dei principali sistemi AI disponibili oggi: da ChatGPT a Claude, da Gemini a Llama (tutti questi modelli poggiano sull’architettura fondamentale del Transformer). Un LLM non “capisce” il linguaggio come lo farebbe un essere umano: è una rete neurale addestrata su miliardi di testi che impara a prevedere, con straordinaria precisione statistica, quale token (parola o sequenza) verrà dopo un dato contesto. La differenza rispetto a un motore di ricerca è sostanziale: un LLM, preso da solo, non recupera una risposta da un archivio ma genera una continuazione sulla base di ciò che ha appreso durante l’addestramento. Il termine “large” si riferisce al numero di parametri, i valori numerici appresi durante l’addestramento, che nei modelli di frontiera raggiungono le centinaia di miliardi. Un LLM è considerato un modello di frontiera quando è tra i più avanzati disponibili in un determinato momento, generalmente sviluppato con grandi quantità di dati, calcolo e tecniche di addestramento all’avanguardia.
Token: è l’unità elementare con cui i modelli linguistici leggono e scrivono. Non corrisponde a una parola: può essere una parola intera, una sua parte, un singolo carattere o un segno di punteggiatura. In inglese un token equivale in media a circa quattro caratteri o tre quarti di parola; per l’italiano, che ha una morfologia più ricca, servono di solito più token per esprimere lo stesso concetto, e questo si traduce in costi d’uso leggermente superiori sulle API. I prezzi di accesso ai modelli tramite interfaccia programmatica sono calcolati per milione di token in input e in output: capire come si contano è uno dei primi strumenti pratici di chiunque lavori professionalmente con l’AI.
Contesto: detto anche context window (finestra di contesto), è la quantità massima di testo che un modello può elaborare in una singola sessione. Comprende il testo fornito dall’utente, le istruzioni di sistema e le risposte precedenti del modello. I modelli moderni hanno finestre di contesto da decine o centinaia di migliaia fino a oltre un milione di token, ma usare tutto il contesto disponibile ha un costo computazionale ed economico crescente. Più il contesto è ampio, più il modello può “ricordare” ciò che è stato scritto, ma l’attenzione si distribuisce su più materiale e alcune informazioni vengono di fatto elaborate con minore intensità (soprattutto quelle a metà).
Embedding: è la rappresentazione di un testo (o di un’immagine, o di qualsiasi altro dato) come vettore numerico: una sequenza ordinata di numeri che cattura il significato semantico. Parole o frasi con significato simile producono vettori vicini nello spazio matematico; parole non correlate risultano lontane. Questa proprietà permette di misurare la somiglianza semantica con operazioni algebriche, ed è alla base dei motori di ricerca semantica, dei sistemi di raccomandazione e della memoria negli agenti AI. Un embedding tipico ha da 768 a oltre 16.000 dimensioni: numeri che traducono relazioni di significato in geometria.
Come nasce un modello
Addestramento: è il processo con cui un modello impara. Si articola in due fasi principali: il pre-addestramento (pre-training), in cui il modello elabora corpus enormi di testo, nell’ordine dei miliardi o migliaia di miliardi di token, imparando a prevedere il token successivo e acquisendo così conoscenza di base su linguaggio, fatti e ragionamento; e il post-addestramento (post-training), che comprende tecniche come il fine tuning supervisionato, l’ottimizzazione delle preferenze e il feedback umano, e definisce il comportamento del modello come assistente. Il pre-addestramento dei modelli di frontiera richiede budget computazionali nell’ordine di centinaia di milioni di dollari. Il post-addestramento è ciò che trasforma un predittore di testo in un sistema utile, coerente e relativamente sicuro: è un investimento minore in termini assoluti, ma determina quasi interamente la qualità percepita dall’utente finale.
MoE: Mixture of Experts, cioè “mix di esperti”, è un’architettura che permette a un modello di grandi dimensioni di non utilizzare tutti i suoi parametri per ogni singolo token. Il modello è diviso in più componenti specializzati, chiamati expert, e un meccanismo di selezione decide quali attivare di volta in volta in base all’input. In questo modo un modello può avere centinaia di miliardi o persino trilioni di parametri complessivi, ma utilizzarne solo una parte durante ogni passaggio, riducendo il costo computazionale dell’inferenza rispetto a un modello dense delle stesse dimensioni. La specializzazione degli expert non significa però che ciascuno impari necessariamente un compito preciso e riconoscibile: è il modello stesso, attraverso l’addestramento, a sviluppare la distribuzione delle competenze. La tecnica è oggi utilizzata in diversi modelli di frontiera perché permette di aumentare la capacità complessiva senza far crescere nella stessa proporzione il costo di ogni singola elaborazione.
Fine tuning: è l’adattamento di un modello già addestrato a un dominio o compito specifico. A differenza dell’addestramento da zero, parte da un modello esistente e lo specializza usando quantità molto minori di dati mirati: esempi di conversazioni mediche per un assistente clinico, testi legali per un consulente giuridico, stile redazionale specifico per un assistente editoriale. Il risultato è un modello che mantiene le capacità generali del modello di base ma eccelle nel dominio per cui è stato affinato. È una tecnica efficace, ma che richiede attenzione: un fine tuning condotto su dati di scarsa qualità può peggiorare le prestazioni anche negli ambiti originali, producendo un modello più specializzato ma complessivamente meno capace.
Inferenza: è il momento in cui il modello produce un output partendo da un input. Mentre l’addestramento è un processo costoso svolto in fasi specifiche dello sviluppo del modello, l’inferenza avviene ogni volta che qualcuno fa una domanda o chiede di generare un testo: è il costo ricorrente, scalabile, di qualsiasi sistema AI. L’ottimizzazione dell’inferenza (ridurre la latenza, abbattere i costi per token, gestire più richieste in parallelo) è diventata uno dei campi più attivi della ricerca applicata. Tecniche come la quantizzazione (riduzione della precisione numerica dei parametri), il pruning (eliminazione dei parametri meno rilevanti) e il caching rendono l’inferenza più efficiente senza sacrificare in modo eccessivo la qualità degli output.
Come lo si controlla
System prompt: è il testo di istruzioni fornito al modello prima dell’inizio di qualsiasi conversazione con l’utente. Non è visibile direttamente a chi usa il sistema, ma definisce il carattere, i limiti, il tono e le regole di comportamento del modello in quel contesto specifico. Un system prompt può specificare come presentarsi, quali argomenti evitare, in quale formato rispondere, quali strumenti usare. È il meccanismo principale con cui sviluppatori e aziende trasformano modelli generici in prodotti specifici, e la sua qualità ha un impatto diretto sull’esperienza d’uso finale: un system prompt mal costruito produce un assistente incoerente anche partendo da un modello eccellente.
Grounding: è il processo che ancora le risposte di un modello a fonti concrete e verificabili, riducendo il rischio di risposte inventate. Un sistema “grounded” non genera risposte attingendo solo alle proprie conoscenze interne, ma recupera informazioni da documenti, database o pagine web prima di rispondere. La tecnica più diffusa è la RAG (Retrieval-Augmented Generation, generazione aumentata dal recupero): il sistema individua nei documenti le porzioni rilevanti e le fornisce al modello come contesto per la risposta. Il grounding non elimina il problema delle allucinazioni, ma lo riduce significativamente quando è implementato con cura e applicato a fonti di qualità verificata.
Guardrails: sono i vincoli, le regole e i meccanismi di sicurezza che limitano i comportamenti indesiderati di un sistema AI. Possono essere implementati a livello di addestramento (insegnando al modello a rifiutare certe richieste), di system prompt (specificando comportamenti vietati) o di infrastruttura (filtri applicati agli output prima che vengano mostrati all’utente). Troppo pochi guardrails lasciano il modello esposto ad usi impropri; troppi lo rendono inutilizzabile anche per usi legittimi. Trovare il punto di equilibrio tra utilità e sicurezza è una delle sfide più difficili nello sviluppo e nel deployment dei sistemi AI moderni, e resta un terreno di confronto aperto tra laboratori, regolatori e utenti.
Quando sbaglia
Allucinazione: è il termine tecnico per un output che un modello linguistico presenta come fatto ma che risulta falso, inventato o privo di fondamento nelle fonti. Non è un bug risolvibile con un aggiornamento: è una conseguenza strutturale del fatto che i modelli di linguaggio sono predittori di token, non database di verità verificata. Le allucinazioni si classificano in tipi diversi: contraddittorie (il modello si contraddice tra un passaggio e l’altro), non fattuali (inventa dati, persone o eventi), fuori contesto (risponde correttamente ma al prompt sbagliato). Ridurle richiede grounding, prompt chiari, modelli con migliori capacità epistemiche e, nei contesti critici, la verifica umana degli output: nessuna singola tecnica le elimina completamente.
Allineamento: è il campo di ricerca che si occupa di garantire che i sistemi AI si comportino in modo coerente con le intenzioni e i valori degli sviluppatori e degli utenti. Un modello “allineato” non è semplicemente uno che esegue gli ordini: è uno che comprende l’obiettivo sottostante a una richiesta, agisce in modo sicuro anche in situazioni non previste durante l’addestramento e non persegue obiettivi propri in contrasto con quelli di chi lo usa. Le tecniche principali includono il feedback umano (RLHF, Reinforcement Learning from Human Feedback), l’ottimizzazione diretta delle preferenze (DPO) e approcci basati su valori espliciti come il Constitutional AI sviluppato da Anthropic. L’allineamento è oggi uno dei campi più critici e al tempo stesso più aperti della ricerca sull’AI: c’è ampio accordo sull’importanza del problema, molto meno sulle soluzioni.
Quando ragiona e agisce
Reasoning: il “ragionamento” indica la capacità di un modello di affrontare un problema attraverso più passaggi intermedi prima di produrre una risposta. Nei moderni reasoning model questa elaborazione può essere svolta internamente e non coincide necessariamente con ciò che viene mostrato all’utente.
Chain of Thought: la tecnica della “catena del pensiero”, spesso abbreviata in CoT, è invece una tecnica o rappresentazione in cui vengono esplicitati passaggi intermedi del ragionamento. I primi lavori sul CoT hanno mostrato miglioramenti soprattutto nei problemi di matematica, logica e pianificazione; i modelli più recenti possono essere addestrati a utilizzare più computazione interna per compiti complessi, senza necessariamente mostrare all’utente la catena completa del loro ragionamento; è uno degli sviluppi più significativi degli ultimi due anni.
Agenti AI: sono sistemi AI in grado di pianificare e svolgere sequenze di azioni complesse per raggiungere un obiettivo, senza che ogni passaggio richieda l’intervento umano. Un agente non si limita a rispondere a una domanda: può navigare il web, leggere documenti, scrivere e testare codice, inviare email, interagire con API esterne e coordinarsi con altri agenti specializzati. La differenza rispetto a un chatbot è la capacità di operare su orizzonti temporali più lunghi, gestire sequenze di decisioni e correggere in modo autonomo i propri errori intermedi. La differenza non è quindi semplicemente che l’agente “fa cose”: è che il modello partecipa alla scelta dei passaggi necessari per raggiungere l’obiettivo. Gli agenti autonomi rappresentano la frontiera attuale dello sviluppo dei sistemi AI: potenti e promettenti, ma ancora soggetti a fallimenti imprevisti che rendono necessaria una supervisione umana attenta.
Come si misura
Harness: letteralmente “inbracatura”, è l’infrastruttura che mette un modello nelle condizioni di svolgere un compito complesso: gestisce strumenti, chiamate, stato, ciclo di esecuzione, ambiente e condizioni di arresto. Nel caso delle valutazioni si parla di evaluation harness, cioè l’ambiente che esegue sistematicamente i test, raccoglie i risultati e li confronta.
Eval: (abbreviazione di evaluation) è un test strutturato per misurare una capacità o un comportamento di un sistema AI. Può essere automatico, umano o ibrido e può valutare tanto la risposta finale quanto, nel caso degli agenti, l’uso degli strumenti, le azioni compiute e lo stato finale dell’ambiente. Le eval sono diventate particolarmente importanti con i sistemi agentici, perché una risposta apparentemente corretta non significa necessariamente che il processo che l’ha prodotta abbia funzionato correttamente. Senza un sistema di valutazione solido, il miglioramento di un modello rimane una questione di impressioni soggettive: ed è esattamente per questo che costruire buoni benchmark è diventato un lavoro a sé.
EASTER EGG (non potevamo non aggiungere una voce “segreta” al nostro piccolo dizionario)
Distillazione: è la tecnica con cui si trasferisce la conoscenza di un modello grande e costoso, detto teacher, a uno più piccolo ed efficiente, detto student. A differenza di quanto potrebbe sembrare, il modello student non impara semplicemente dalle risposte del teacher: impara imitandone le distribuzioni di probabilità, cioè il modo in cui il modello grande distribuisce la propria “incertezza” tra le possibili risposte, catturando così sfumature che i soli dati di addestramento non trasmetterebbero. Il risultato è un modello più leggero, adatto al deployment su dispositivi con vincoli di latenza, memoria o consumo energetico, che preserva buona parte delle capacità del modello originale. La distillazione è diventata una tecnica strategica negli ultimi anni, con diversi modelli di frontiera usati come teacher per creare varianti compatte distribuite a costi molto inferiori: permette a gruppi di lavoro più piccoli di accedere a capacità avanzate senza sostenere i costi proibitivi dell’addestramento da zero.
Ovviamente il dizionario potrebbe continuare: il campo evolve rapidamente e i termini si moltiplicano di mese in mese. Ciò che resta stabile è la distinzione tra comprensione tecnica e narrazione, spesso semplicistica, che circola attorno a questi strumenti. Un buon vocabolario non risolve l’ambiguità, ma almeno aiuta a nominarla con precisione.