Dal 1952 al 1997 il sociologo tedesco Niklas Luhmann tenne uno schedario che arrivò a circa 90mila schede, ciascuna con rimandi ad altre: il valore stava nei collegamenti più che nella quantità. Quel sistema, lo Zettelkasten, è l’antenato del Second Brain, il secondo cervello.
La memoria umana genera intuizioni ma le conserva male. È un problema che un archivio esterno, affidabile, aiuta a risolvere: se il cervello non si deve più preoccupare di ricordare, può concentrarsi sul creare. Così gli appunti diventano progetti, proposte, codice.
| Fase | Periodo | Novità | Limite |
|---|---|---|---|
| Schedario di carta | 1952-1997 | Rimandi tra schede | Manutenzione a mano |
| App di note | Anni Duemila | Ricerca e tag | Si salva tanto, si riusa poco |
| Markdown | Dal 2004 | File di testo portabili | Serve disciplina |
| Intelligenza artificiale | Dal 2022 | Ricerca per significato | Risposte senza fonte |
Tiago Forte, consulente e autore, ha sistematizzato questa pratica in un metodo chiamato CODE, articolato in quattro operazioni: catturare, organizzare, distillare ed esprimere. A questo si affianca PARA, il sistema che organizza le informazioni in quattro categorie: progetti, aree di responsabilità, risorse e archivi.
Nasce tutto con il testo puro. Rispetto a Niklas Luhmann che lo usava con carta e penna (o macchina per scrivere) per riempire le sue 90mila schede, oggi lo stesso principio è scrivere in Markdown, terreno perfetto sul quale poi lavorano gli agenti di intelligenza artificiale. Pochi immaginano però che il markdown è arrivato al Secondo Brain prima degli agenti AI.
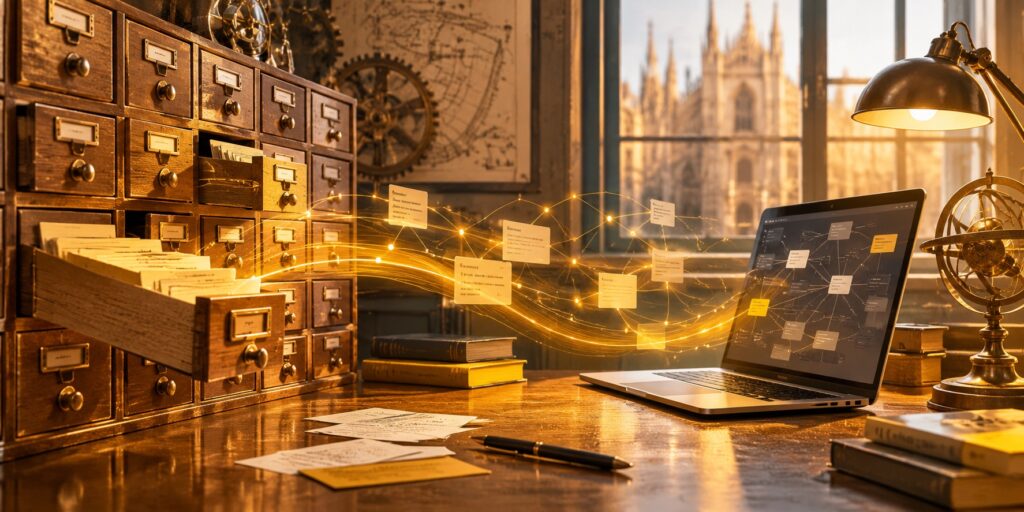
Nel 2004 John Gruber, con il contributo di Aaron Swartz, pubblicò Markdown: pochi simboli (il cancelletto per i titoli, l’asterisco per l’enfasi) bastano a strutturare un documento. Un file così si apre con qualsiasi programma, si versiona con Git e si lascia leggere da una macchina senza fatica. Obsidian vi ha costruito sopra il proprio laboratorio: il “vault” (il forziere) è una cartella di file di testo sul disco, con collegamenti bidirezionali.
Il vantaggio? È totalmente privo di vendor lock-in: cambiare programma è immediato e costa zero (a parte i plugin dell’app stessa, se non sono replicati altrove).
L’intelligenza artificiale entra nel vault
Con i modelli generativi interrogare l’archivio diventa economico: ricerca per significato, riassunti, recupero dei passaggi pertinenti da fornire al modello come contesto (la tecnica si chiama Rag, retrieval-augmented generation). Il rischio di questo tipo di operazioni sono le allucinazioni, le risposte plausibili ma prive di fonte, e per questo le fonti devono restare nel vault.
Gli agenti e gli scenari
Un agente pianifica, chiama strumenti e tiene il contesto lungo più passaggi. Il Model Context Protocol (Mcp), protocollo aperto, lo collega a dati e servizi esterni in modo standard. A un vault curato si può chiedere un brief sul mercato delle app per appunti: l’agente cerca le note su concorrenti e ricerche precedenti, interroga fonti web autorizzate, scrive la bozza in Markdown con riferimenti e attende l’approvazione prima di salvare o inviare. Senza vault, le risposte restano generiche.
Alla fine, tutto dipende dall’architettura: permessi graduati (lettura, proposta, scrittura, invio), registro delle azioni, revisione umana per le decisioni irreversibili. E poiché un vault di file di testo passa da un modello all’altro senza perdite, sopravvive anche al cambio di fornitore.
Alcune fonti di questo articolo:
- niklas-luhmann-archiv.de/bestand
- buildingasecondbrain.com
- fortelabs.com/blog/para/
- spec.commonmark.org/spec
- obsidian.md/help/bases
- nist.gov/itl/ai-risk-management-framework
- developers.openai.com/api/docs/guides/function-calling
- modelcontextprotocol.io